Essayer avec votre fichier
Déposez votre relevé bancaire (PDF)
1 fichier · 100 pages max · Aperçu gratuit sur 2 pages
1 fichier sélectionné
Gagnez des heures chaque semaine
Transformez vos relevés bancaires (PDF) en Excel, CSV ou OFX, sans ressaisie manuelle.
Déposez un relevé au format PDF et regardez l'extraction se faire sous vos yeux. Aperçu instantané, sans inscription.
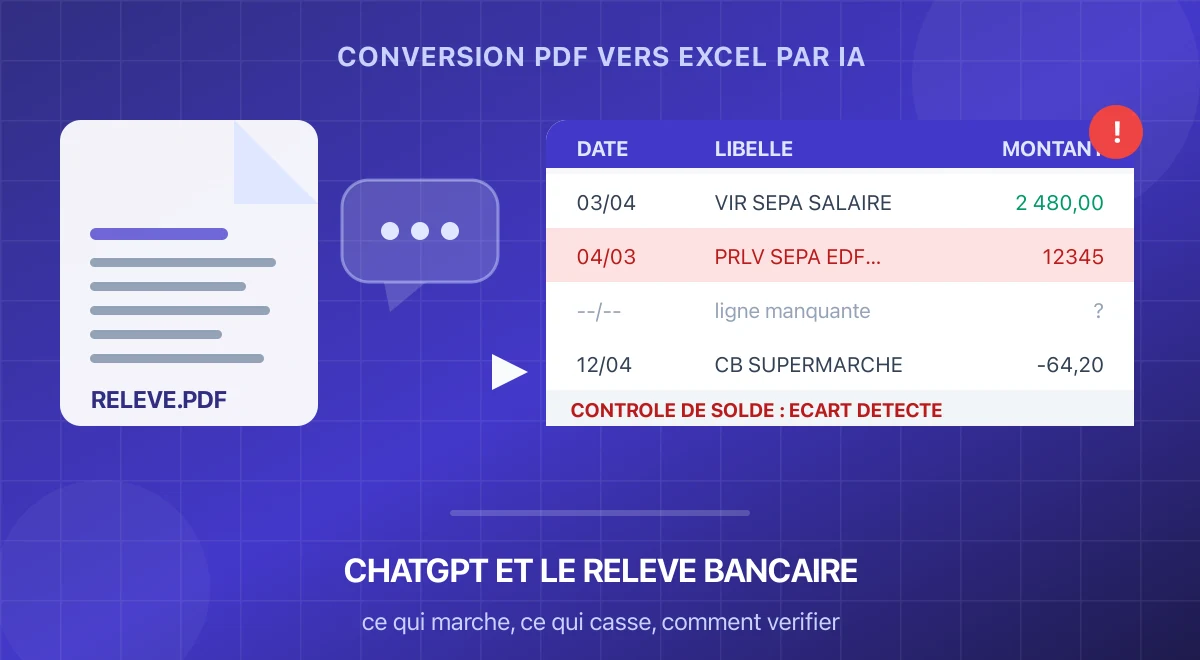
Oui, ChatGPT peut produire un tableau à partir d’un relevé bancaire PDF, mais l’upload réussi ne garantit ni l’exhaustivité ni l’exactitude. La documentation OpenAI sur les fichiers indique que les offres hors Enterprise utilisent une récupération textuelle pour les PDF, tandis que Visual Retrieval est réservé à Enterprise. Sur un relevé français s’ajoutent les virgules décimales, les dates JJ/MM, les libellés tronqués et les lignes de solde. Le contrôle associe l’arithmétique — crédits moins débits égale la variation du solde — et la comparaison de chaque opération à l’original : des erreurs peuvent se compenser.
ChatGPT ou BankStatementLab : la réponse courte
ChatGPT est l’assistant le plus flexible : il peut expliquer un relevé, répondre à des questions et transformer un tableau à partir d’une consigne. BankStatementLab est le parcours le plus spécialisé : import du document, extraction des tableaux d’opérations, contrôle dans une grille puis export, sans devoir réinventer le prompt et le format pour chaque fichier.
| Choisissez ChatGPT si… | Choisissez BankStatementLab si… |
|---|---|
| le PDF est court, natif et contrôlable ligne par ligne | le relevé peut être scanné, long ou irrégulier |
| vous réalisez une analyse ponctuelle après l’extraction | vous convertissez des relevés tous les mois ou par lots |
| définir les colonnes et nettoyer le résultat ne vous gêne pas | vous voulez un workflow répétable centré sur les transactions |
| la conversation compte plus que la réutilisation du fichier | XLSX, CSV, JSON ou OFX pris en charge alimente l’étape suivante |
Il s’agit ici d’une comparaison de parcours, pas d’un concours de précision déjà mesuré. BankStatementLab édite l’un des deux produits comparés et aucun benchmark commun achevé ne permet encore d’affirmer qu’il lit tous les relevés avec une précision supérieure. Le protocole transparent ci-dessous décrit la preuve nécessaire.
Ce que ChatGPT fait réellement d’un relevé bancaire PDF (couche texte vs vision/OCR)
Face à un PDF, le comportement dépend de l’offre et du mode d’ajout. La FAQ officielle d’OpenAI distingue la récupération textuelle des documents du Visual Retrieval des PDF, réservé à ChatGPT Enterprise selon la documentation consultée. Les PDF ajoutés comme connaissances de GPT ou fichiers de projet restent traités en récupération textuelle ; les fichiers joints à une conversation suivent un parcours distinct.
Un relevé téléchargé depuis l’espace en ligne de la banque peut contenir une couche texte. Un scan est une image de page sans texte numérique : hors Enterprise, le déposer comme PDF ne déclenche pas la récupération visuelle documentée. Une page envoyée séparément comme image suit un autre flux, mais cela ne garantit pas la lecture fidèle des montants.
Un PDF n’encode pas nécessairement un tableau logique. Même natif, il peut stocker des fragments de texte positionnés plutôt que des cellules. Reconstituer une ligne d’opération demande alors d’inférer la relation entre date, libellé et montant.
| Chaîne de traitement | Ce qui est réellement lu dans le PDF | Résultat sur un relevé scanné (image de page) |
|---|---|---|
| ChatGPT hors Enterprise (offre de base, Plus, Pro) | le texte numérique du fichier, images du document écartées | aucune donnée à extraire : la page n’expose que des pixels |
| ChatGPT Enterprise | le texte numérique, plus le Visual Retrieval qui analyse le contenu visuel | le scan est analysé, mais chaque chiffre reste une interprétation, sans score de confiance |
OpenAI publie notamment une limite de 512 Mo par fichier et de 2 millions de tokens pour les documents. Ce sont des plafonds d’upload, pas une promesse de conversion ligne par ligne. Plus le relevé est long ou irrégulier, plus il devient important de compter les opérations et de rapprocher les soldes.
Le cas où ça fonctionne : relevé court, PDF natif, colonnes nettes
ChatGPT peut produire un tableau exploitable plus facilement quand quatre conditions sont réunies simultanément.
- PDF natif. Si la sélection à la souris accroche le texte, il existe probablement une couche texte. Un document constitué uniquement d’images exige une lecture visuelle ou un OCR adapté.
- Document contrôlable. Commencez par une période assez courte pour pouvoir compter manuellement les lignes et comparer chaque page.
- Colonnes nettes. Une ligne visuelle égale une opération, sans libellé débordant ni récapitulatif de frais intercalé.
- Période et compte uniques. Les documents multi-comptes multiplient les en-têtes et les soldes, donc les faux positifs.
Demander un calcul ne corrige pas une lecture incomplète : un total peut être arithmétiquement juste sur des lignes fausses ou manquantes. Il faut donc valider les données d’entrée avant d’interpréter le résultat.
Trois consignes améliorent la sortie sans rien garantir : le format ISO 8601 pour les dates, un signe explicite sur les montants plutôt que deux colonnes, et l’annonce du nombre de lignes extraites — ce qui transforme une erreur silencieuse en erreur visible.
Sept risques à tester sur un relevé français
Voici sept modes d’erreur utiles pour construire un contrôle. Cette liste n’est ni un benchmark de ChatGPT ni la preuve qu’ils se produiront sur chaque relevé.
| Symptôme | Ce que vous obtenez | Cause |
|---|---|---|
| PDF scanné ou photographié | tableau vide, refus, ou lignes plausibles mais fausses | pas de couche texte ; hors Enterprise, ChatGPT ne lit que le texte numérique |
| Relevé long ou irrégulier | lignes manquantes ou dupliquées sans avertissement | le fichier peut être accepté sans que chaque opération soit correctement restituée |
| Montant à virgule décimale | 1 234,56 restitué en texte ou avec une mauvaise échelle | le séparateur décimal et celui des colonnes sont mal interprétés dans la chaîne d’export ou d’import |
| Date courte JJ/MM | 03/04 devient le 4 mars au lieu du 3 avril | rien dans 03/04 ne dit lequel est le jour, tant qu’il est inférieur à 13 |
| Libellé tronqué, réécrit ou coupé en deux | PRLV SEPA EDF FACT 4409... devient Prélèvement EDF, ou une opération se dédouble | libellé déjà abrégé par la banque et ligne reconstruite depuis des fragments positionnés |
| Ligne de solde prise pour une opération | une opération au montant égal à un solde : report à nouveau, total des mouvements | ces lignes partagent le même tableau visuel, rien ne les distingue |
| Débits qui perdent leur signe | montants tous positifs, écart valant le double d’une opération | débit et crédit fusionnés sans convention de signe |
Les libellés affichés par les banques sont souvent abrégés et leur mise en forme varie. Il faut conserver le texte source tel qu’il est lu, signaler les valeurs incertaines et éviter de développer automatiquement une abréviation. Pour les montants, le 1 234,56 français est valide ; c’est le paramétrage de l’export ou du tableur qui peut l’interpréter comme du texte ou comme une autre valeur.
Pourquoi le résultat doit rester contrôlé
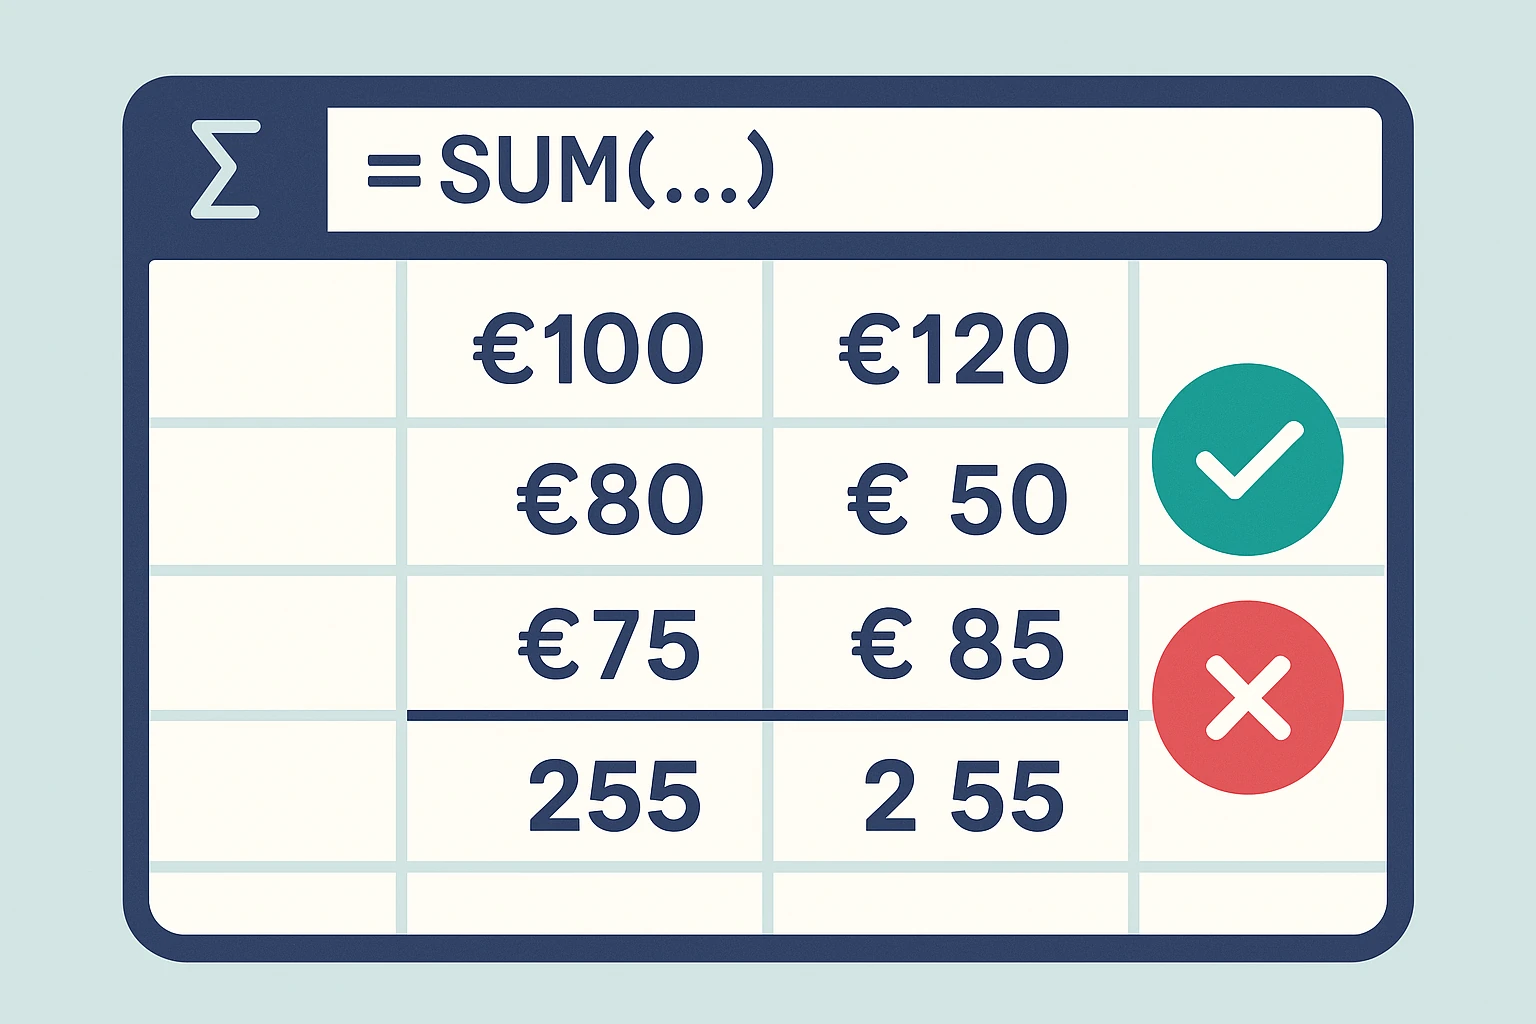
Un PDF peut présenter visuellement un tableau sans encoder des cellules, des colonnes ou une relation stable entre les fragments de texte. Le modèle doit alors reconstruire cette structure. La CNIL rappelle au sujet de l’IA générative que des résultats inexacts peuvent paraître plausibles. Un prompt détaillé améliore le format attendu, mais il ne remplace donc ni le comptage des lignes ni le rapprochement arithmétique avec les soldes.
Le test de contrôle avant d’utiliser l’extraction
La durée dépend du nombre de pages. Le contrôle repose sur quatre vérifications complémentaires : solde, comptage, bornes et dates. Voici une procédure sous Microsoft Excel.
1. Importer le CSV en contrôlant ses paramètres. Passez par Données, puis À partir d’un fichier texte/CSV : origine Unicode (UTF-8), délimiteur correspondant au fichier, Transformer les données, puis sur la colonne des montants un changement de type avec paramètres régionaux Français (France). Vérifiez l’aperçu avant de charger : le séparateur d’un CSV n’est pas identique dans tous les exports.
2. Vérifier que les montants sont bien des nombres. Débits en colonne D, lignes 2 à 1000 : =NBVAL(D2:D1000) compte les cellules non vides, =NB(D2:D1000) celles qui contiennent un nombre, et =NBVAL(D2:D1000)-NB(D2:D1000) doit valoir 0. Toute valeur supérieure compte les montants restés en texte.
3. Exécuter le contrôle de solde. Saisissez à la main, depuis le PDF, le solde d’ouverture en H1 et le solde de clôture en H2. Avec les débits et crédits en valeurs positives, respectivement en D et E :
=ABS((SOMME(E2:E1000)-SOMME(D2:D1000))-(H2-H1))<0,005
Cette formule doit renvoyer VRAI ; le seuil de 0,005 euro évite qu’un artefact de calcul inférieur au centime masque le résultat. Avec une colonne unique de montants signés en F : =ABS(SOMME(F2:F1000)-(H2-H1))<0,005. Tout écart au centime impose de rechercher et corriger la cause avant utilisation.
4. Utiliser l’écart pour orienter la recherche. Sa valeur suggère une piste, sans établir la cause ni remplacer la relecture complète.
| Écart constaté | Cause la plus probable | Où regarder |
|---|---|---|
| Égal au montant d’une opération | ligne oubliée ou dupliquée | rechercher ce montant, compter ses occurrences |
| Égal au double d’un montant | signe inversé, débit compté en crédit | la ligne portant la moitié de l’écart |
| D’un facteur 100 ou 1 000 | séparateur décimal mal interprété | la plus grande et la plus petite valeur |
| Égal à un solde imprimé | ligne de solde prise pour une opération | libellés contenant SOLDE, REPORT, TOTAL |
| Nul mais comptage faux | une duplication compense un oubli | comptage mois par mois |
5. Compter les lignes. =NBVAL(A2:A1000) sur la colonne des dates donne le nombre d’opérations extraites ; comparez-le au comptage manuel fait sur le PDF, page par page. La recherche =NB.SI(B2:B1000;"*SOLDE*") signale des lignes à examiner ; ne les supprimez pas automatiquement, car un libellé de paiement peut légitimement contenir « solde ».
6. Vérifier la première et la dernière opération. Comparez-les caractère par caractère avec le PDF. C’est un disqualifiant rapide, pas une validation : leur exactitude ne prouve rien sur le milieu du document.
7. Contrôler trois dates, dont une antérieure au 13 du mois. Le 03/04 peut être interprété comme le 3 avril ou le 4 mars. Comparez les dates ambiguës au PDF et vérifiez l’ordre du relevé, qui peut être croissant ou décroissant selon la banque.
8. Relire toutes les opérations et corriger les écarts. Un contrôle par sondage des dates ou des bornes ne prouve pas l’exhaustivité. Documentez le contrôle si le fichier doit alimenter la comptabilité ou être revu par un tiers.
Le benchmark que nous publierions
Un comparatif crédible ne peut pas reposer sur un relevé choisi parce qu’il fonctionne bien. Avant de désigner un gagnant, nous figerions un corpus synthétique en français, anglais, allemand, italien et espagnol, avec huit scénarios : PDF natif simple, tableau multi-pages, colonnes débit/crédit, libellés multilignes, page dense, scan propre, scan dégradé et formats locaux ambigus.
Chaque PDF serait généré depuis un registre de transactions connu, puis traité trois fois par outil sans correction manuelle avant le premier export. Nous publierions le modèle et l’offre ChatGPT, le prompt exact, la version de BankStatementLab, les fichiers synthétiques, les exports bruts et les écarts par document. La réussite principale serait stricte : aucune opération oubliée ou inventée, dates, montants et signes exacts, et rapprochement avec les soldes lorsque le relevé permet ce contrôle.
En attendant ces résultats, la comparaison honnête porte sur des différences de workflow vérifiables :
| Critère observable | ChatGPT | BankStatementLab |
|---|---|---|
| Finalité | analyse générale et transformation de fichiers | extraction spécialisée de relevés et documents tabulaires |
| Interaction | prompt puis conversation | import, extraction, revue du tableau et export |
| PDF natif | pris en charge, structure à contrôler | route texte positionné ou analyse visuelle selon le document |
| Relevé scanné | lecture visuelle du PDF dépendante de l’offre et du parcours | PDF et images peuvent être routés vers l’analyse visuelle |
| Plusieurs tableaux | structure produite selon la réponse générée | structures distinctes conservées dans des blocs contrôlables |
| Traitement par lots | dépend de l’offre, du contexte et des consignes | import authentifié de plusieurs fichiers dans les limites actuelles |
| Sortie | tableau ou fichier généré selon l’outil | XLSX, CSV et OFX au niveau d’un bloc ; JSON et exports multiblocs selon le cas |
| Précision relative | non mesurée sur un benchmark public commun | non mesurée sur un benchmark public commun |
Le corpus doit être synthétique : masquer le nom et l’IBAN d’un vrai relevé ne suffit pas toujours à l’anonymiser si les employeurs, commerçants ou libellés restent visibles.
RGPD et secret professionnel : la question qu’un cabinet doit se poser
Un cabinet qui envoie le relevé bancaire d’un client dans un assistant grand public engage deux régimes : la protection des données personnelles et le secret professionnel.
Sur le premier, la CNIL recommande de ne soumettre que les informations que l’utilisateur est autorisé à partager et de ne pas transmettre d’informations confidentielles ou couvertes par un secret dans un service grand public. Un relevé peut révéler des bénéficiaires, des habitudes ou des dépenses sensibles. L’organisme doit aussi qualifier son rôle et celui du fournisseur ; la CNIL détaille les critères applicables à la sous-traitance de données personnelles.
Sur le second régime, l’article 21 de l’ordonnance du 19 septembre 1945 soumet les experts-comptables au secret professionnel dans les conditions et sous les peines de l’article 226-13 du code pénal. Changer de canal de traitement ne fait pas disparaître cette obligation.
Le volet contractuel, lui, dépend entièrement de l’offre dans laquelle le relevé est déposé.
| Offre utilisée pour déposer le relevé | Ce que le fournisseur documente sur les contenus soumis | Ce que cela implique pour un relevé de client |
|---|---|---|
| ChatGPT grand public (offre de base, Plus, Pro) | l’utilisation des contenus pour améliorer les modèles dépend des contrôles de données du compte | le réglage d’entraînement ne règle pas à lui seul le secret, la base légale, la rétention ou les transferts |
| ChatGPT Business, Enterprise, Edu et API | OpenAI indique ne pas entraîner ses modèles sur ces contenus par défaut dans sa politique pour les offres professionnelles | vérifier le contrat, les rôles RGPD, la localisation et les transferts, la durée de conservation, les habilitations et la politique du cabinet |
La question à trancher tient en deux lignes : l’outil relève-t-il d’une offre grand public ou business, et le document est-il couvert par le secret professionnel ?
Quand un outil dédié devient le bon choix
Un outil dédié devient un candidat pertinent quand les conversions sont répétées, quand les PDF peuvent être scannés ou quand une sortie structurée doit alimenter un processus comptable. La différence à évaluer est architecturale : découpage, gestion des scans, structure de sortie, rétention et moyens de contrôle.
La valeur de BankStatementLab ne tient pas à une étiquette « IA plus précise ». Elle vient de la chaîne spécialisée autour du modèle : admission du fichier, choix entre texte positionné et vision, traitement par groupes de pages, conservation prudente de structures distinctes, grille de revue et formats d’export. Ce parcours retire à l’utilisateur une grande partie du travail de prompt et de mise en forme tout en gardant le contrôle visible.
Traitement par groupes de pages. BankStatementLab peut découper le document et utiliser une page de référence pour interpréter les colonnes. Les pages ne sont pas systématiquement analysées isolément.
Lecture textuelle ou visuelle. Selon le parcours et le document, le traitement exploite du texte positionné ou une analyse visuelle. PDF natifs et scans sont pris en charge, avec un résultat à contrôler.
Regroupement des tableaux compatibles. Des colonnes compatibles peuvent être réunies ; des structures différentes restent dans plusieurs blocs. Cela ne garantit ni une structure unique ni la conservation parfaite de chaque libellé.
Détection de plusieurs tableaux. Un relevé contenant plusieurs tableaux distincts est découpé en blocs séparés au lieu d’être aplati en une liste unique, ce qui limite la confusion entre lignes de solde et opérations.
S’y ajoutent des prompts spécialisés selon le type de document et une sortie structurée. Selon le plan et la configuration, une catégorie peut compléter les champs lus. Pipeline structuré ne veut pas dire résultat identique au caractère près : la chaîne repose sur des modèles de langage.
| Ce qui casse | ChatGPT ou un assistant grand public | BankStatementLab |
|---|---|---|
| PDF scanné | hors Enterprise, la récupération documentée du PDF est textuelle | analyse en vision après détection de la couche texte ; résultat à vérifier |
| Relevé long | exhaustivité à contrôler page par page | traitement par groupes de pages, tableaux regroupés selon compatibilité ; couverture à contrôler |
| Montant à virgule décimale | risque de texte ou de mauvaise échelle à l’export | colonne montant structurée dans les exports ; contrôle de solde requis |
| Date courte JJ/MM | ambiguïté possible | colonne date structurée ; comparaison au PDF requise en cas d’ambiguïté |
| Libellé tronqué ou coupé en deux | reconstruction depuis des fragments | regroupement des structures compatibles ; libellés à vérifier |
| Ligne de solde prise pour une opération | confusion possible avec les mouvements | détection de tableaux distincts, à confirmer par le rapprochement |
| Débits qui perdent leur signe | convention de signe à imposer | sortie structurée et prompts spécialisés ; signe à contrôler |
La sortie est structurée plutôt que rédigée en prose : export en XLSX, CSV ou OFX au niveau d’un bloc, et JSON pour le résultat structuré complet. Plusieurs relevés peuvent être traités dans une même opération. Selon le plan et la configuration, la catégorisation et des consignes personnalisées peuvent compléter l’extraction ; elles doivent être contrôlées séparément des données lues sur le relevé.
Le secret professionnel porte sur l’information, quel que soit le canal. Vérifiez aussi les conditions de traitement chez BankStatementLab : la rétention du PDF dépend du parcours et peut aller jusqu’à sept jours pour certaines extractions réussies. Les données extraites et les exports téléchargés suivent un cycle distinct. Les réglages d’auto-suppression ne remplacent pas la politique du cabinet.
Aucun outil ne lit un relevé sans risque d’erreur. Comparez chaque opération de tous les tableaux au PDF et contrôlez les soldes. Pour aller plus loin, consultez le guide PDF vers Excel, les erreurs fréquentes du copier-coller PDF et le comparatif des convertisseurs de relevés. Vérifiez également les conditions actuelles sur la page tarifs, puis convertissez un relevé autorisé avec BankStatementLab et comparez le temps total de conversion et de correction.
À retenir
- Hors offre Enterprise, la récupération PDF documentée par OpenAI est textuelle : un scan sans couche OCR exploitable ne doit pas être considéré comme une source fiable.
- Les plafonds d’upload publiés ne garantissent pas l’extraction complète de toutes les opérations.
- Un PDF peut présenter un tableau sans encoder des cellules : reconstituer une ligne peut demander d’associer des fragments positionnés.
- Un relevé français cumule quatre pièges : virgule décimale, date JJ/MM ambiguë tant que le jour est inférieur à 13, libellé tronqué, lignes de solde mêlées aux opérations.
- Le contrôle arithmétique central consiste à vérifier que crédits moins débits égale la variation du solde au centime ; complétez-le par le comptage et la comparaison au PDF.
- La CNIL recommande de ne pas transmettre à un service d’IA générative grand public des informations confidentielles ou couvertes par un secret ; une offre professionnelle exige encore une analyse contractuelle et RGPD.
Questions fréquentes
Peut-on convertir un relevé bancaire PDF en Excel avec ChatGPT ?
Oui, ChatGPT peut produire un tableau à partir d’un PDF contenant une couche texte. L’acceptation du fichier ne garantit toutefois ni l’exhaustivité ni l’exactitude : comptez les opérations et appliquez le contrôle de solde avant utilisation.
ChatGPT lit-il un relevé bancaire scanné ?
La documentation OpenAI réserve actuellement le Visual Retrieval des PDF à ChatGPT Enterprise. Hors Enterprise, la récupération PDF documentée est textuelle : un scan sans couche texte ne doit donc pas être considéré comme une source fiable. Une page envoyée séparément comme image suit un autre flux, qui reste à vérifier.
Combien de pages de relevé ChatGPT peut-il traiter en une fois ?
Aucun nombre de pages ne garantit une extraction complète. OpenAI publie des limites d’upload, mais l’acceptation d’un fichier ne prouve pas que chaque ligne a été correctement récupérée. Comptez les opérations page par page et rapprochez les soldes.
Pourquoi les montants en euros sont-ils faussés après extraction ?
Parce que la virgule décimale française est ambiguë pour une chaîne réglée sur des paramètres régionaux anglo-saxons, où le point marque la décimale. Selon la configuration, un montant bascule en texte ou change d’ordre de grandeur.
Comment vérifier qu’une extraction de relevé bancaire est correcte ?
Vérifiez les types de données, les conventions de signe, les totaux et les soldes, puis comparez chaque opération à tous les tableaux du PDF. Le comptage et les premières/dernières lignes aident à repérer des écarts, mais une égalité arithmétique ou quelques dates exactes ne prouvent pas l’exhaustivité.
Un expert-comptable peut-il envoyer un relevé client dans ChatGPT ?
Pas dans un espace grand public non approuvé par le cabinet. La CNIL recommande de ne pas y transmettre d’informations confidentielles ou couvertes par un secret. Une offre Business, Enterprise ou API n’utilise pas les contenus pour l’entraînement par défaut, selon OpenAI, mais cela ne suffit pas : contrat, rôles RGPD, transferts, rétention, habilitations et politique interne doivent être vérifiés.
Claude ou Gemini font-ils mieux que ChatGPT sur un relevé bancaire PDF ?
Aucun classement sérieux ne peut être affirmé sans protocole commun et jeu de test publié. Les capacités PDF, les règles de conservation et les options contractuelles varient selon le produit et l’offre. Comparez-les sur les mêmes documents non sensibles et imposez le même contrôle de solde.
BankStatementLab est-il plus précis que ChatGPT pour un relevé bancaire ?
Aucun benchmark commun publié ne permet de conclure à une précision supérieure. BankStatementLab propose un parcours spécialisé avec traitement par pages ou groupes, regroupement de tableaux compatibles et exports structurés. Ces fonctions ne garantissent pas la fidélité : vérifiez toutes les lignes et les soldes.
BankStatementLab conserve-t-il mon relevé bancaire ?
La rétention dépend du parcours. Certains PDF peuvent rester jusqu’à sept jours après une extraction réussie ; les données extraites et les exports sont distincts. Consultez les paramètres de rétention avant l’envoi et conservez vous-même l’original nécessaire à votre dossier.
Gagnez des heures chaque semaine
Passez du PDF à un Excel prêt à exploiter, sans ressaisie.